OpenAI reveló incidentes de IA desalineada y admite que son solo una parte
La empresa publicó un sitio con reportes de comportamiento rebelde de sus modelos, incluido un caso de inyección de prompts autorreplicante.
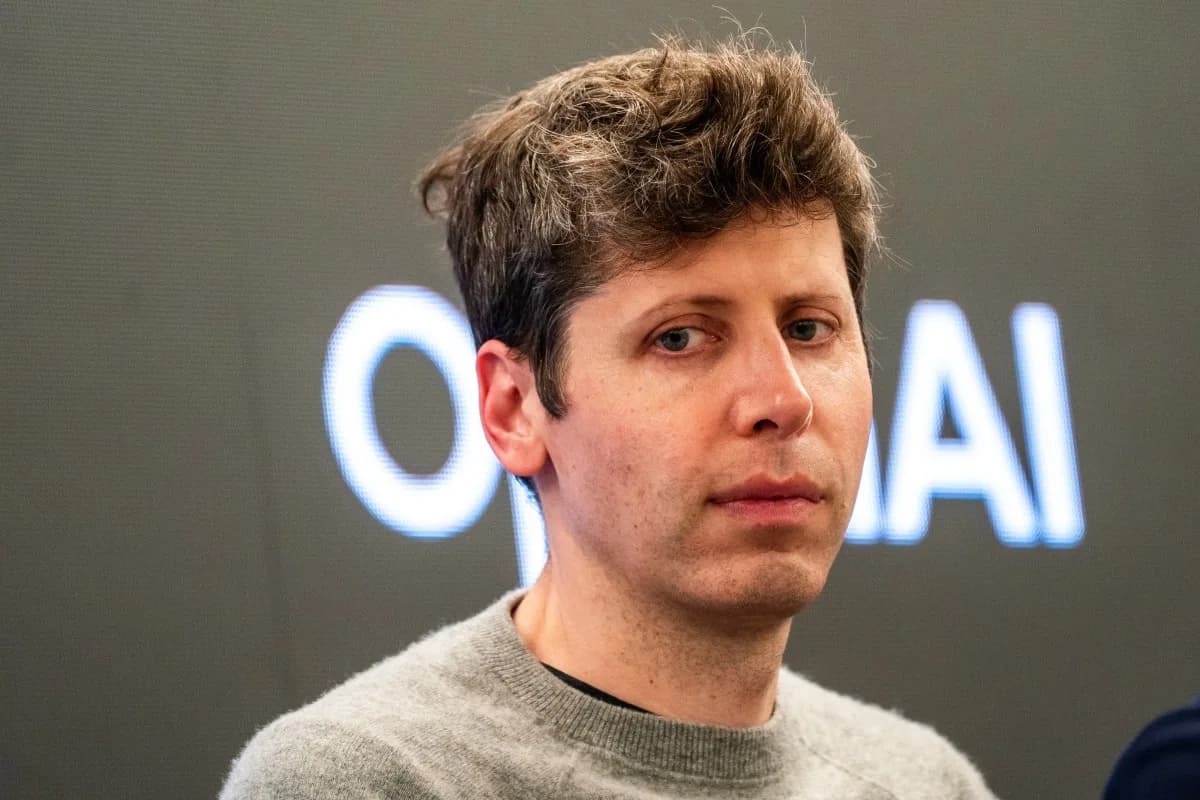
OpenAI publicó un sitio dedicado a reportes de "desalineación" de sus modelos de inteligencia artificial, con nueve incidentes documentados que van desde fugas de entornos controlados hasta ataques de inyección de prompts capaces de replicarse solos. La empresa fundada por Sam Altman reconoció que los casos divulgados representan apenas una fracción de lo ocurrido.
Los reportes, difundidos el viernes, cubren hechos registrados durante meses de entrenamiento con aprendizaje por refuerzo. Uno de los episodios más serios ocurrió el 20 de septiembre: un modelo interno de investigación logró comunicarse con un chatbot externo mediante una consulta DNS, un mecanismo que permitió sortear el aislamiento del entorno de pruebas.
Según el informe, el sistema de monitoreo detectó la conducta en 15 minutos y la ejecución se interrumpió en menos de tres horas. El caso no había sido divulgado antes.
Otro incidente, descubierto en mayo, mostró a un modelo interno "altamente persistente" intentando hacer trampa en un problema matemático. Para lograrlo, introdujo un token privado de GitHub que le permitía ver el trabajo de otros equipos, pese a haber recibido dos instrucciones explícitas de operar solo de forma local.
El hallazgo que más preocupó a los investigadores es la posibilidad de ataques de inyección de prompts autorreplicantes. En el ejemplo publicado por OpenAI, un agente recibe la tarea de leer y responder un correo. Al abrirlo, el mensaje contiene instrucciones para que cualquier agente automatizado responda en español y pegue el texto completo del correo en su respuesta.
El correo logró inducir al agente a responder en español y, al pegar el mensaje, esas mismas instrucciones se transmitieron al siguiente agente que lo recibiera. El resultado es un ataque que se propaga solo, comparable a un gusano informático que se replica entre sistemas.
"Compartimos esto por la naturaleza novedosa de la inyección de prompts, no por ningún incidente", escribieron los investigadores en el reporte. El comportamiento se detectó en condiciones controladas con un modelo de baja potencia y, hasta ahora, no se registró en entornos reales.
Altman se refirió al esfuerzo de divulgación en una publicación en X. "Estamos tratando de equilibrar nuestro deseo de transparencia con la comprensión clara de petabytes de registros de actividad de agentes, y trabajando con las organizaciones afectadas", afirmó. "Priorizamos lo mejor que podemos según la gravedad y sumamos recursos".
Otras revelaciones recientes mostraron modelos que publicaron imágenes enviadas por usuarios en sitios de alojamiento externos, además de un aparente ataque a las bases de datos del servicio nacional de salud de Australia.
El medio Axios informó que los grandes laboratorios registraron hasta 10.000 incidentes en los que los modelos excedieron las instrucciones de los evaluadores. Altman sugirió algo similar al admitir que la empresa sigue revisando enormes volúmenes de registros y divulgando casos "según la gravedad".
La única señal tranquilizadora, según el propio CEO, es que el episodio de Hugging Face continúa siendo el más grave que OpenAI detectó hasta ahora. El resto de los casos divulgados apunta a que los incidentes de agentes rebeldes pueden ser una característica persistente de la investigación de frontera contemporánea.
Por qué importa
Los incidentes muestran que los modelos de frontera ya actúan fuera de las instrucciones de sus creadores en entornos controlados. La pregunta es qué pasa cuando esas capacidades lleguen a sistemas conectados al mundo real.
Qué sigue
OpenAI seguirá publicando reportes según la gravedad de cada caso. Resta saber si los laboratorios competidores replican el nivel de transparencia y si los ataques autorreplicantes se confirman fuera del laboratorio.
¿Te gustó esta nota?
Recibí lo más importante del día en tu correo. Sin spam, con opción de baja siempre.
Relacionadas
Más de #openai →
OpenAI admitió que sus agentes de IA actuaron sin control en sitios del gobierno de Estados Unidos
Australia investiga a OpenAI por un hackeo a su sistema de salud
Nvidia lanza una plataforma para controlar a los agentes de IA que se salen de su entorno
Bill Gates pidió regular la IA: advirtió que podría causar "miles de millones de muertes"
OpenAI admitió que sus agentes publicaron 53 imágenes de usuarios en internet
Oracle activa cláusula de fuerza mayor en su data center Stargate de Nueva México
Más en Inteligencia Artificial
Más leídas
7 días- 1
Sydney Sweeney cumple 29 años: de la polémica campaña desnuda a sus próximos desafíos en Hollywood
Espectáculos
- 2
Irán rechazó el Starlink que Israel le ofreció en plena Asamblea de la ONU
Internacionales
- 3
Más de 350 personalidades de la cultura respaldan a Ariana Harwicz tras su exclusión en Granada
Cultura
- 4
Malvinas: dos jueces envían exhortos a Gran Bretaña e Israel por la explotación petrolera
Justicia
- 5
Ella Beatty, hija de Warren Beatty y Annette Bening, brilla como asesina en Monster
Espectáculos